订单列表只显示20条数据。查订单的SQL加了分页,客户表也有主键索引,日志里却连续出现20条查客户的语句。
问题往往藏在组装返回值的循环里:
var page = mapper.page(afterId);
var result = new ArrayList();
for (Order order : page) {
    String name = mapper.customerName(
        order.customerId());
    result.add(new Row(
        order.id(), displayName(name)));
}
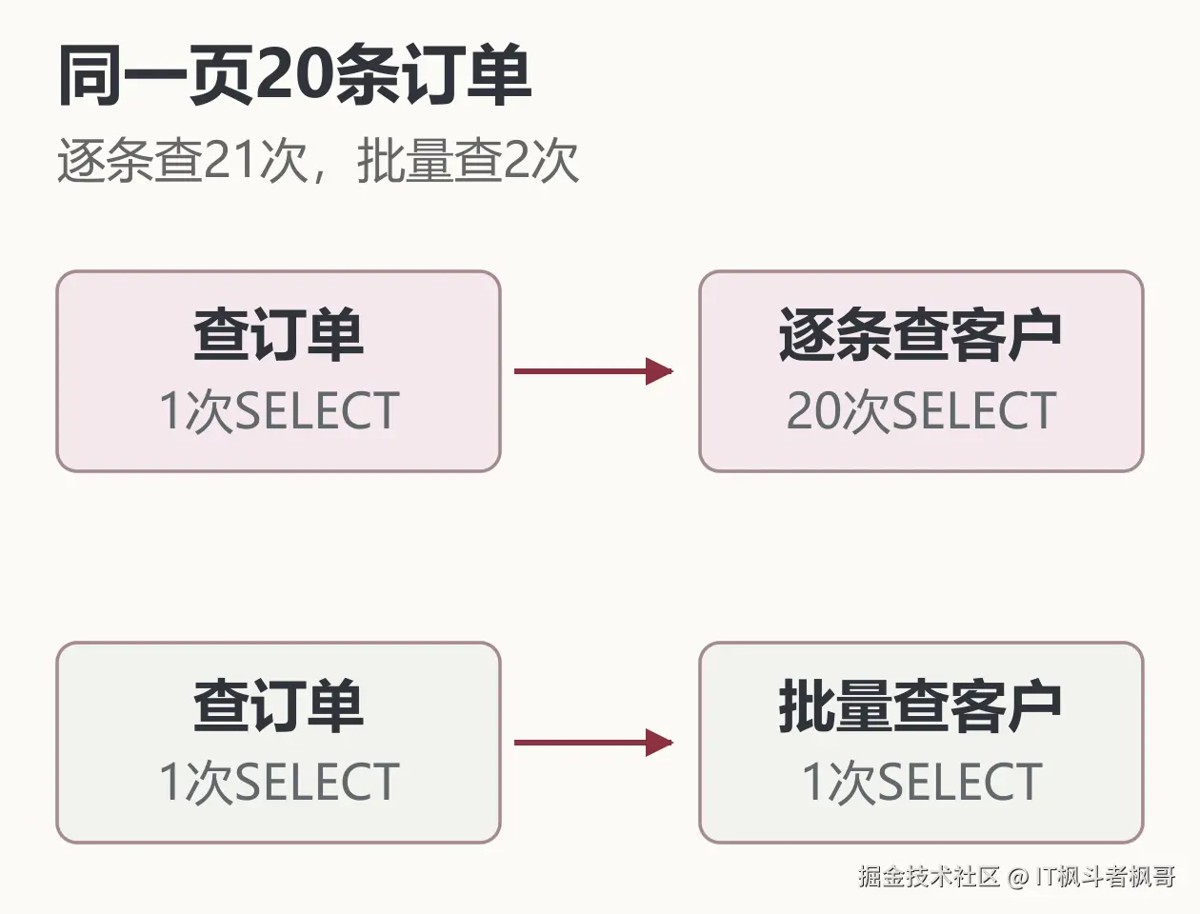
这段代码每拿到一个订单,就调用一次 customerName。当这页订单对应20个不同客户时,一次列表读取会执行21次查询:先查订单,再查20次客户。这就是常见的N+1查询:1次主查询,后面跟着N次关联查询。
改法是先收齐这页的客户ID,一次查回名称,再按订单顺序组装。 下面用MyBatis 3.5.19实际跑这两种写法,普通页的查询次数从21次降到了2次,返回的20条订单完全一致。
分页保留,把查客户移到循环外
订单查询继续只取当前页,不需要为了批量补名称,把所有订单都读出来。
SELECT id, customer_id
FROM orders
WHERE id > #{afterId}
ORDER BY id
LIMIT 20
拿到这一页后,收集客户ID并去重。接下来按这些ID查客户,用Map保存“客户ID → 客户名称”的对应关系。
服务层改成下面这样:
static List batch(
        OrderMapper mapper, int afterId) {
    List page = mapper.page(afterId);
    // 空页直接返回,不生成 IN ()。
    if (page.isEmpty()) return List.of();

    List ids = page.stream()
        .map(Order::customerId).distinct().toList();
    Map names = new HashMap();
    for (Customer customer : mapper.customers(ids)) {
        names.put(customer.id(), customer.name());
    }

    var result = new ArrayList();
    // 客户查询刻意倒序返回,仍按订单页的顺序组装。
    for (Order order : page) {
        result.add(new Row(order.id(),
            displayName(names.get(order.customerId()))));
    }
    return result;
}
mapper.customers(ids) 使用 foreach 生成 IN 条件,查询部分如下:
SELECT id, name FROM customers WHERE id IN

    #{id}

ORDER BY id DESC
Mapper参数使用 @Param("ids") 命名。#{id} 绑定预处理参数,不把ID直接拼成SQL字符串。注解Mapper里的动态SQL需要放在 中,文末完整代码已经包含它。MyBatis动态SQL文档有对应用法。
这里故意让客户按ID倒序返回,订单仍按ID正序。这样可以检验:组装代码有没有错误地把两个列表按下标配对。
查询返回的先后顺序不能用来判断客户属于哪个订单,客户ID才可以。 Map查找用的是ID,最后的循环走的是原订单列表,所以客户查询顺序变化不会打乱页面。
少查19次,也不能少掉一条订单
我给程序准备了20条订单,其中第7条指向的客户资料不存在。两种方案都把它显示为“客户资料缺失”,保留这条订单。
实际输出的结果是:
普通页:逐条 21 次,批量 2 次
20 条订单的顺序与名称一致:true
第 7 条:Row[orderId=7, customerName=客户资料缺失]
如果批量查询后直接遍历客户列表生成页面行,这条订单就会消失。缺失关联数据的处理必须沿用原来的业务约定;这里采用占位名称,项目要求报错时就保留报错行为。
空页也检查了:订单查询没有结果,直接返回空列表,总共1次查询。不要继续向Mapper传空集合,生成一条没有有效 IN 条件的SQL。
还有两个容易漏掉的条件。原查询如果带租户或数据权限限制,批量查询也要保留;如果页面要求订单与客户资料来自同一快照,需要按业务要求处理事务和数据库隔离,不能把拆成两次读取默认当作一致性保证。
本例一页只有20个ID。把这个方法用到大批量数据时,需要根据数据库参数限制和执行计划决定是否分段,不能把整张表的ID一次塞进 IN。
开了一级缓存,为什么还值得改?
20条订单不一定每次都查21次。
我把第2条订单的客户改成第1条的客户,再跑逐条查询。同一个 SqlSession 内,第二次相同的客户查询命中了一级缓存,实际查询从21次变成了20次:
重复客户:逐条 20 次,批量 2 次
程序保留了 localCacheScope=SESSION,没有为了凑出21次而关闭缓存。两种方案各开一个新会话,避免前一组查询给后一组预热。
一级缓存能减少同一会话里的重复查询,但这页剩余的客户ID仍然不同,缓存不能把它们自动合成一条批量SQL。MyBatis配置文档说明了会话缓存的范围。
所以排查时要看实际执行的SQL,不能数一下Mapper调用,就把它当成数据库查询次数。下面的程序在 StatementHandler.query 上计数,缓存命中的查询不会经过这个位置;建表和准备数据的语句不计入结果。
这次改动收掉了循环里的逐条查询。至于线上接口能快多少,还要在相同数据和负载下测耗时,21次变2次不能直接换算成快了10倍。
能JOIN,为什么还要分两次查?
如果只是订单关联唯一客户、取一个名称,LEFT JOIN 完全可以作为候选,未必需要先查订单再查客户。选哪种写法,要结合现有Mapper职责、索引和执行计划。
这里保留两次查询,是为了演示如何改掉现有服务层里的循环查库。关联对象换成订单明细时,还要重新考虑分页:一笔订单有多条明细,连接后 LIMIT 20 限制的是结果行数,未必还能得到20笔订单。先确定订单页,再取关联数据,可以保留按订单分页的含义。
下次遇到列表接口查询多,先找到循环中的数据库调用:这批ID能否在进入循环前收齐?如果可以,通常就有机会把逐条读取合并起来。改完再用同一页数据核对查询次数、顺序和缺失记录,别只看日志变短了。
把代码跑一遍
下面是完整的Maven示例,只需要JDK 21和Maven,不需要另装数据库。我运行时用的是JDK 21.0.11、MyBatis 3.5.19、H2 2.3.232;H2使用内存库,启动时创建上述20条订单。
新建目录,放入这两个文件:
mybatis-query-lab/
├── pom.xml
└── src/main/java/demo/QueryLab.java
pom.xml:
4.0.0demomybatis-query-lab1.021UTF-8org.mybatismybatis3.5.19com.h2databaseh22.3.232org.apache.maven.pluginsmaven-compiler-plugin3.13.0org.codehaus.mojoexec-maven-plugin3.5.0demo.QueryLab
src/main/java/demo/QueryLab.java:
package demo;

import java.sql.Statement;
import java.util.*;
import org.apache.ibatis.annotations.*;
import org.apache.ibatis.datasource.unpooled.UnpooledDataSource;
import org.apache.ibatis.executor.statement.StatementHandler;
import org.apache.ibatis.mapping.Environment;
import org.apache.ibatis.plugin.*;
import org.apache.ibatis.session.*;
import org.apache.ibatis.transaction.jdbc.JdbcTransactionFactory;

public class QueryLab {
    public record Order(int id, int customerId) {}
    public record Customer(int id, String name) {}
    public record Row(int orderId, String customerName) {}

    public interface OrderMapper {
        @Select("""
            SELECT id, customer_id FROM orders
            WHERE id > #{afterId} ORDER BY id LIMIT 20
            """)
        @ConstructorArgs({
            @Arg(column = "id", javaType = int.class),
            @Arg(column = "customer_id", javaType = int.class)
        })
        List page(@Param("afterId") int afterId);

        @Select("SELECT name FROM customers WHERE id = #{id}")
        String customerName(@Param("id") int id);

        @Select("""

            SELECT id, name FROM customers WHERE id IN

                #{id}

            ORDER BY id DESC

            """)
        @ConstructorArgs({
            @Arg(column = "id", javaType = int.class),
            @Arg(column = "name", javaType = String.class)
        })
        List customers(@Param("ids") List ids);
    }

    // 本文程序单线程运行,只统计真正进入 StatementHandler 的查询。
    @Intercepts(@Signature(type = StatementHandler.class,
        method = "query", args = {Statement.class, ResultHandler.class}))
    public static class QueryCounter implements Interceptor {
        final List sql = new ArrayList();
        public Object intercept(Invocation invocation) throws Throwable {
            var handler = (StatementHandler) invocation.getTarget();
            sql.add(handler.getBoundSql().getSql()
                .replaceAll("\s+", " ").trim());
            return invocation.proceed();
        }
    }

    static List oneByOne(
            OrderMapper mapper, int afterId) {
        var page = mapper.page(afterId);
        var result = new ArrayList();
        for (Order order : page) {
            String name = mapper.customerName(
                order.customerId());
            result.add(new Row(
                order.id(), displayName(name)));
        }
        return result;
    }

    static List batch(
            OrderMapper mapper, int afterId) {
        List page = mapper.page(afterId);
        // 空页直接返回,不生成 IN ()。
        if (page.isEmpty()) return List.of();

        List ids = page.stream()
            .map(Order::customerId).distinct().toList();
        Map names = new HashMap();
        for (Customer customer : mapper.customers(ids)) {
            names.put(customer.id(), customer.name());
        }

        var result = new ArrayList();
        // 客户查询刻意倒序返回,仍按订单页的顺序组装。
        for (Order order : page) {
            result.add(new Row(order.id(),
                displayName(names.get(order.customerId()))));
        }
        return result;
    }

    static String displayName(String name) {
        return name == null ? "客户资料缺失" : name;
    }

    static List run(SqlSessionFactory factory, QueryCounter counter,
                         boolean useBatch, int afterId) {
        counter.sql.clear();
        // 两种方案各用一个新会话,避免前一组预热后一组的缓存。
        try (SqlSession session = factory.openSession()) {
            var mapper = session.getMapper(OrderMapper.class);
            return useBatch ? batch(mapper, afterId)
                            : oneByOne(mapper, afterId);
        }
    }

    static void require(boolean ok, String message) {
        if (!ok) throw new AssertionError(message);
    }

    public static void main(String[] args) throws Exception {
        var ds = new UnpooledDataSource(
            "org.h2.Driver", "jdbc:h2:mem:query_lab", "sa", "");
        // 保持此连接打开,让两个 SqlSession 使用同一份内存数据。
        try (var keeper = ds.getConnection();
             var setup = keeper.createStatement()) {
            setup.execute("CREATE TABLE orders "
                + "(id INT PRIMARY KEY, customer_id INT NOT NULL)");
            setup.execute("CREATE TABLE customers "
                + "(id INT PRIMARY KEY, name VARCHAR(60) NOT NULL)");
            for (int i = 1; i
在 pom.xml 所在目录运行:
mvn -q compile exec:java
除了前面的结果,程序还会打印批量方案实际执行的两条SQL,并检查空页、重复客户和缺失客户。它把客户查询刻意倒序;你可以去掉 ORDER BY id DESC 再运行,订单页仍应保持原顺序。
到此这篇关于MyBatis实现列表查询优化的实用技巧分享的文章就介绍到这了,更多相关MyBatis列表查询优化内容请搜索IT俱乐部以前的文章或继续浏览下面的相关文章希望大家以后多多支持IT俱乐部!